Informatika Kelas X — Bab 6: Analisis Data
Bagian G: Pengumpulan Data Otomatis — Web Scraping
Pengampu : Zuli Irawanto, ST
🎯 Tujuan Pembelajaran
Setelah mempelajari materi ini, siswa diharapkan mampu:
- Menjelaskan pengertian web scraping dan manfaatnya untuk mengumpulkan data.
- Menerapkan etika dan aturan dasar dalam mengambil data dari situs web.
- Membaca struktur sederhana HTML (tag, atribut, dan class).
- Mengambil data dari halaman web memakai pustaka
requestsdan BeautifulSoup, lalu menyimpannya dalam DataFrame.
Apa Itu Web Scraping?
Di Bagian A kita tahu bahwa tahap pertama analisis data adalah koleksi data. Bagaimana kalau datanya ada di sebuah situs web, misalnya daftar harga 1.000 buku? Menyalinnya satu per satu dengan tangan sangat melelahkan.
Web scraping adalah teknik mengambil data dari halaman web secara otomatis memakai program. Program kita bertugas “membaca” halaman web seperti manusia, lalu mencatat bagian yang kita butuhkan ke dalam tabel.
requests membuka alamat web⚖️ Etika dan aturan scraping, wajib dipahami!
- Ambil data publik saja. Jangan mengambil data pribadi orang lain atau halaman yang memerlukan login tanpa izin.
- Periksa aturan situs (syarat penggunaan dan berkas
robots.txt). Ada situs yang melarang scraping. - Jangan membebani server: jangan mengirim permintaan terlalu sering atau terlalu banyak.
- Hargai hak cipta. Sebutkan sumber data bila hasilnya dipakai atau dibagikan.
- Di materi ini kita berlatih di books.toscrape.com, situs khusus yang memang dibuat untuk latihan scraping.
Cara Belajar Bagian Ini
Bagian ini berisi 5 Tugas Praktik, yaitu Praktik 29 sampai 33 (melanjutkan Bagian F). Polanya masih sama: 🤔 Tebak dulu → ⌨️ Ketik & jalankan → ✅ Cocokkan → 💡 Pahami → 🏁 Tantangan mini.
requests dan BeautifulSoup sudah terpasang di Colab. Praktik 31 sampai 33 membutuhkan koneksi internet.🧪 Tugas Praktik 29: Mengintip HTML Sebuah Halaman Web
🖱️ Lakukan langkah ini di browser (laptop/komputer):
- Buka books.toscrape.com.
- Klik kanan pada judul salah satu buku, lalu pilih Inspect (atau tekan F12).
- Perhatikan baris yang ter-highlight di panel kode. Itulah HTML halaman tersebut.
✅ Yang akan kamu temukan (disederhanakan):
<article class="product_pod">
  <h3><a href="..." title="A Light in the Attic">A Light in the ...</a></h3>
  <p class="price_color">51.77</p>
</article>
💡 Penjelasan: HTML tersusun dari tag yang diapit tanda < >. Tiap tag biasanya punya pembuka dan penutup (<p> ... </p>). Perhatikan bahwa judul lengkap buku tersimpan di atribut title pada tag <a>, sedangkan teks yang tampil dipotong. Untuk scraping, kita perlu tahu tag, atribut, dan class tempat data berada. (Catatan: pada halaman aslinya, angka harga didahului satu simbol mata uang asing. Abaikan saja, di praktik berikutnya kita hanya mengambil angkanya.)
| Bagian HTML | Artinya | Data yang kita ambil |
|---|---|---|
<article class="product_pod"> |
Satu kotak buku (kelas product_pod) |
Wadah satu buku |
<h3><a title="..."> |
Judul; isi lengkapnya ada di atribut title |
Judul buku |
<p class="price_color"> |
Paragraf dengan class price_color |
Harga buku |
🧪 Tugas Praktik 30: Membaca HTML dengan BeautifulSoup
<li>?⌨️ Ketik di sel kode, lalu jalankan:
from bs4 import BeautifulSoup

html = """
<html><body>
  <h1>Daftar Nilai</h1>
  <ul>
    <li class="siswa">Budi: 87</li>
    <li class="siswa">Sari: 90</li>
    <li class="siswa">Andi: 75</li>
  </ul>
</body></html>
"""

soup = BeautifulSoup(html, "html.parser")
print(soup.h1.text)

for item in soup.find_all("li"):
    print(item.text)
✅ Hasilnya:
Daftar Nilai
Budi: 87
Sari: 90
Andi: 75
💡 Penjelasan: Teks yang diapit tiga tanda kutip """ ... """ boleh terdiri dari banyak baris. BeautifulSoup(html, "html.parser") mengubah HTML menjadi objek yang mudah ditelusuri. soup.h1.text mengambil tulisan di dalam tag <h1>, sedangkan find_all("li") mengumpulkan semua tag <li> dalam bentuk list, yang bisa kita proses dengan for (Bagian E). Perhatikan: di Python kodenya ditulis dengan tanda kurung siku/kurung biasa, sedangkan tanda < > hanya ada di dalam teks HTML.
<li class="siswa">Dedi: 82</li> ke dalam HTML, lalu jalankan lagi. Apa yang berubah?🧪 Tugas Praktik 31: Mengambil Halaman Web dengan requests
⌨️ Ketik di sel kode, lalu jalankan:
import requests
from bs4 import BeautifulSoup

url = "https://books.toscrape.com/"
r = requests.get(url)

print(r.status_code)

soup = BeautifulSoup(r.content, "html.parser")
print(soup.title.text.strip())
✅ Hasilnya:
200
All products | Books to Scrape - Sandbox
💡 Penjelasan: requests.get(url) mengirim permintaan ke situs, mirip membuka alamat di browser. r.status_code adalah kode jawaban dari situs: 200 berarti berhasil, 404 berarti halaman tidak ditemukan. Isi halaman (HTML) disimpan di r.content, lalu diubah menjadi soup seperti di Praktik 30. soup.title.text mengambil judul halaman, dan .strip() membuang spasi atau baris kosong di pinggir. Catatan: hasil ini diambil dari situs langsung, jadi tampilannya bisa sedikit berbeda bila situs berubah.
url menjadi "https://books.toscrape.com/halaman-ngawur". Apa status_code-nya?🧪 Tugas Praktik 32: Mengambil Judul dan Harga Buku
⌨️ Ketik di sel kode, lalu jalankan:
buku = soup.find_all("article", class_="product_pod")
print("Jumlah buku:", len(buku))

for b in buku[:3]:
    judul = b.h3.a["title"]
    teks = b.find("p", class_="price_color").text
    harga = teks[1:]
    print(f"{judul} - {harga}")
✅ Hasilnya:
Jumlah buku: 20
A Light in the Attic - 51.77
Tipping the Velvet - 53.74
Soumission - 50.10
💡 Penjelasan: find_all("article", class_="product_pod") mengumpulkan semua kotak buku (sesuai hasil Inspect di Praktik 29) ke dalam list buku. Untuk tiap buku, judul diambil dari atribut title (ditulis b.h3.a["title"]), dan harga dari tag p ber-class price_color. Teks harga diawali satu simbol mata uang yang tidak kita perlukan, jadi kita ambil mulai dari karakter kedua dengan teks[1:] (slicing, sama seperti pada list di Bagian D). Potongan buku[:3] adalah slicing dari Bagian D. Praktik ini memakai soup dari Praktik 31. Harga dan judul bisa berbeda bila situs memperbarui isinya.
buku[:3] menjadi buku[:5] atau buku agar semua 20 buku tampil.🧪 Tugas Praktik 33: Menyimpan Hasil Scraping ke DataFrame
⌨️ Ketik di sel kode, lalu jalankan:
import pandas as pd

judul = []
harga = []

for b in buku:
    judul.append(b.h3.a["title"])
    teks = b.find("p", class_="price_color").text
    harga.append(float(teks[1:]))

df = pd.DataFrame({"Judul": judul, "Harga": harga})

print(df.shape)
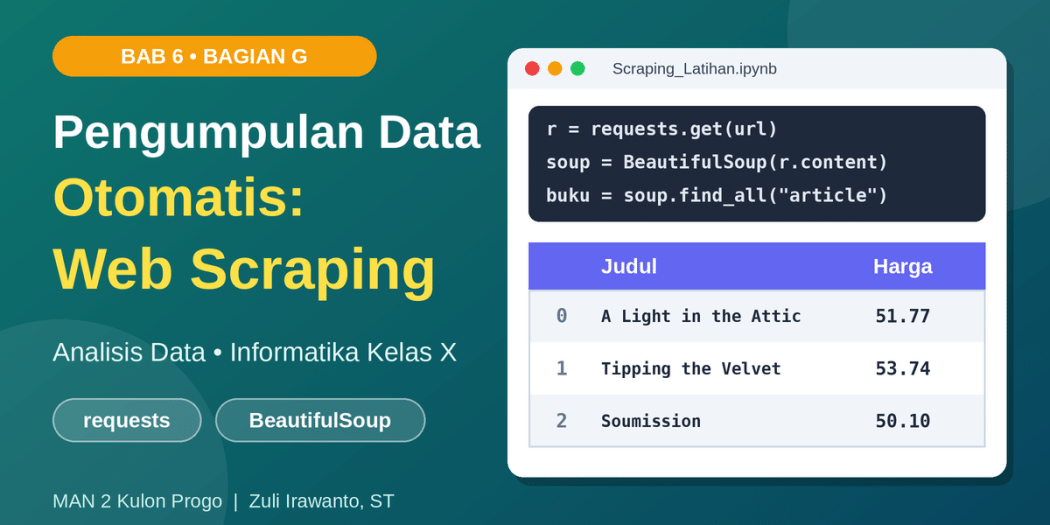
print(df.head(3))
✅ Hasilnya:
(20, 2)
                    Judul  Harga
0    A Light in the Attic  51.77
1      Tipping the Velvet  53.74
2              Soumission  50.10
💡 Penjelasan: Kita menyiapkan dua list kosong, lalu mengisinya lewat perulangan dengan append(). Harga awalnya berupa teks yang diawali satu simbol. Simbol itu dibuang dengan teks[1:], lalu sisanya diubah menjadi angka desimal dengan float() (ingat tipe data di Bagian C!). Setelah itu data siap diolah dengan pandas, misalnya df["Harga"].mean() atau df.sort_values("Harga") seperti di Bagian F. Selamat! 🎉 Kamu telah menyelesaikan alur koleksi data otomatis dari awal sampai tabel.
df.sort_values("Harga").head(3).Rangkuman
- Web scraping adalah teknik mengambil data dari halaman web secara otomatis, dan menjadi tahap koleksi data dalam analisis data.
- Lakukan scraping dengan etis: ambil data publik, patuhi aturan situs (
robots.txt), jangan membebani server, dan sebutkan sumber. - HTML tersusun dari tag, atribut, dan class. Gunakan Inspect di browser untuk menemukan lokasi data.
requests.get()mengambil halaman, danstatus_code200 berarti berhasil.- BeautifulSoup memudahkan pencarian data:
find_all(),.text, dan atribut seperti["title"]. - Hasil scraping disimpan ke list, lalu dijadikan DataFrame untuk dianalisis dengan pandas.
🌱 Pengayaan (Opsional)
Untuk mengecek apakah sebuah situs mengizinkan scraping, tambahkan /robots.txt di belakang alamat situs tersebut di browser, misalnya https://books.toscrape.com/robots.txt. Berkas itu berisi aturan bagian mana yang boleh dan tidak boleh diambil oleh program.
Situs asli seperti toko online atau media sering memiliki aturan ketat, bahkan menyediakan API resmi untuk mengambil data dengan cara yang diizinkan. Di Bagian H kita akan belajar membersihkan dan merapikan data hasil pengumpulan.
💗 Nilai Panca Cinta: Cinta Diri dan Sesama
Kemampuan scraping adalah kekuatan, dan kekuatan perlu disertai akhlak. Menghormati aturan situs, tidak mengambil data pribadi orang lain, tidak membebani server, dan menyebut sumber adalah bentuk menghargai hak sesama. Dengan bersikap jujur dan bertanggung jawab di dunia digital, kita menjaga diri sendiri dari masalah, sekaligus menjaga kenyamanan orang lain. Itulah wujud cinta diri dan sesama.
Refleksi: Apa yang kamu rasakan bila data pribadimu (foto, nomor HP) diambil dan disebarkan orang lain tanpa izin? Apa yang bisa kamu lakukan agar tidak melakukannya pada orang lain?
📝 Tugas Siswa
Tugas Mandiri: Analisis Harga Buku dari Hasil Scraping
Setelah menyelesaikan Praktik 29–33, buat satu notebook baru bernama Tugas_Scraping_NamaKamu, lalu kerjakan di situs books.toscrape.com:
- Ambil judul dan harga seluruh buku di halaman pertama, lalu simpan dalam DataFrame (ubah harga menjadi angka).
- Tampilkan jumlah buku, harga rata-rata, harga termurah, dan harga termahal.
- Tampilkan buku yang harganya di bawah 20 (petunjuk: filter DataFrame seperti Bagian F).
- Tuliskan di sel teks sumber data dan satu aturan etika scraping yang kamu patuhi.
| Pertanyaan | Jawaban |
|---|---|
| Tautan (link) notebook | … |
| Jumlah buku dan harga rata-rata | … |
| Harga termurah dan termahal | … |
| Jumlah buku dengan harga di bawah 20 | … |
| Kendala yang dialami & cara mengatasinya | … |
Sebutkan dua contoh data yang boleh dan dua contoh data yang tidak boleh diambil dengan scraping. Jelaskan alasanmu.Jawaban: …………………………………………………………………
Kerjakan di Colab, lalu kumpulkan tautan notebook melalui link/aplikasi yang diinformasikan guru (sesuai kondisi dan kesepakatan dengan guru pengampu). Jika tidak memungkinkan memakai laptop, boleh dicatat dan difoto di buku tugas.