Informatika Kelas X — Bab 6: Analisis Data
Bagian H: Pembersihan dan Pembingkaian Data
Pengampu : Zuli Irawanto, ST
🎯 Tujuan Pembelajaran
Setelah mempelajari materi ini, siswa diharapkan mampu:
- Menjelaskan alasan data mentah perlu dibersihkan sebelum dianalisis.
- Mengenali masalah umum pada data: data ganda, data kosong, teks tidak seragam, dan tipe data salah.
- Membersihkan data memakai pandas (
drop_duplicates,fillna,dropna,str.strip,astype). - Membingkai data yang sudah bersih ke dalam DataFrame yang rapi dan merangkumnya per kelompok.
Mengapa Data Perlu Dibersihkan?
Data hasil pengumpulan (Bagian G) jarang langsung rapi. Ada nilai yang kosong, ada nama yang tercatat dua kali, ada tulisan yang tidak seragam. Kalau data seperti itu langsung dianalisis, hasilnya bisa menyesatkan. Ada ungkapan terkenal di dunia komputer: “garbage in, garbage out”, artinya masukan yang buruk menghasilkan keluaran yang buruk.
Membersihkan data itu seperti mencuci beras sebelum dimasak. Kerikil dan kotoran dibuang dulu, baru nasinya enak dan aman dimakan. Dalam analisis data, tahap ini adalah tahap kedua: pembersihan.
Empat masalah yang paling sering muncul:
| Masalah | Contoh | Akibat bila dibiarkan |
|---|---|---|
| Data ganda | Siswa “Sari” tercatat 2 kali | Rata-rata dan jumlah jadi keliru |
| Data kosong | Nilai Andi belum terisi (NaN) |
Perhitungan error atau tidak akurat |
| Teks tidak seragam | "x-1", " X-1", "X-1 " |
Dianggap kelas yang berbeda-beda |
| Tipe data salah | Nilai tersimpan sebagai teks "87" |
Tidak bisa dijumlahkan atau dirata-ratakan |
Pembingkaian data (data framing) adalah menyusun data yang sudah bersih ke dalam DataFrame (tabel dengan baris dan kolom yang rapi) supaya siap dirangkum, dibandingkan, dan divisualisasikan.
drop_duplicates()fillna() atau dropna()str.strip(), astype()Cara Belajar Bagian Ini
Bagian ini berisi 5 Tugas Praktik, yaitu Praktik 34 sampai 38 (melanjutkan Bagian G). Polanya masih sama: 🤔 Tebak dulu → ⌨️ Ketik & jalankan → ✅ Cocokkan → 💡 Pahami → 🏁 Tantangan mini.
df dari sel sebelumnya, jadi jalankan sel dari atas ke bawah secara berurutan. Praktik 38 berdiri sendiri.🧪 Tugas Praktik 34: Memeriksa Data yang Kotor
⌨️ Ketik di sel kode, lalu jalankan:
import pandas as pd

data = {
    "Nama": ["Budi", "Sari", "Andi", "Sari", "Dedi", "Rina"],
    "Kelas": ["X-1", "X-1", "X-2", "X-1", "X-2", "X-1"],
    "Nilai": [87, 90, None, 90, 75, 82]
}
df = pd.DataFrame(data)

print(df)
print()
print(df.isnull().sum())
print("Data ganda:", df.duplicated().sum())
✅ Hasilnya:
   Nama Kelas  Nilai
0  Budi   X-1   87.0
1  Sari   X-1   90.0
2  Andi   X-2    NaN
3  Sari   X-1   90.0
4  Dedi   X-2   75.0
5  Rina   X-1   82.0

Nama     0
Kelas    0
Nilai    1
dtype: int64
Data ganda: 1
💡 Penjelasan: Tabel ini sengaja dibuat kotor. Nilai Andi kosong, ditulis NaN (singkatan Not a Number), dan baris Sari muncul dua kali. df.isnull().sum() menghitung data kosong di setiap kolom. Hasilnya, kolom Nilai punya 1 data kosong. df.duplicated().sum() menghitung baris yang menggandakan baris sebelumnya, dan hasilnya 1. Pemeriksaan seperti ini selalu dilakukan lebih dulu sebelum membersihkan. Catatan: nilai berubah menjadi 87.0 (desimal) karena kolom yang berisi NaN bertipe desimal.
None). Apa hasil isnull().sum() sekarang?🧪 Tugas Praktik 35: Menghapus Data Ganda
⌨️ Ketik di sel kode, lalu jalankan:
print("Sebelum:", df.shape)

df = df.drop_duplicates()
print("Sesudah:", df.shape)

df = df.reset_index(drop=True)
print(df)
✅ Hasilnya:
Sebelum: (6, 3)
Sesudah: (5, 3)
   Nama Kelas  Nilai
0  Budi   X-1   87.0
1  Sari   X-1   90.0
2  Andi   X-2    NaN
3  Dedi   X-2   75.0
4  Rina   X-1   82.0
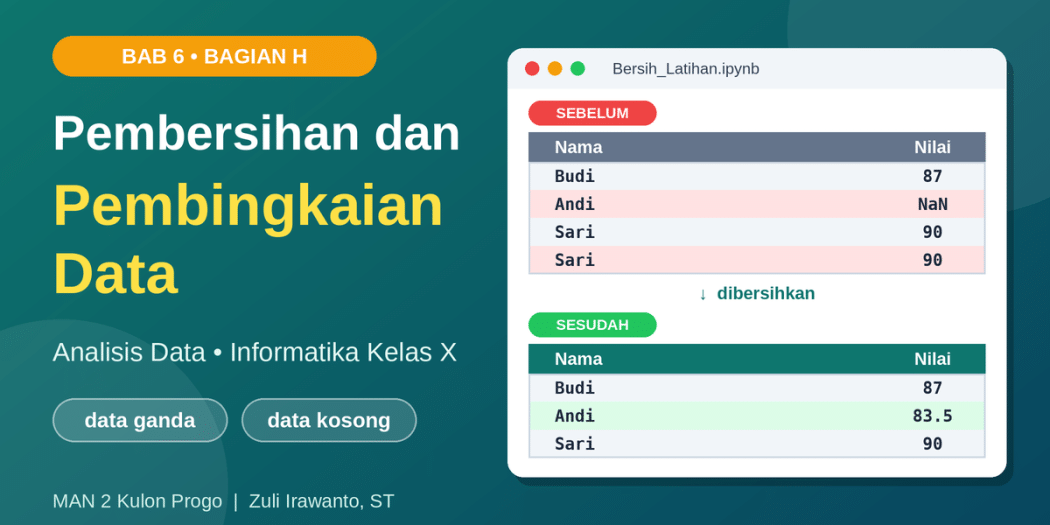
💡 Penjelasan: drop_duplicates() menghapus baris yang sama persis dengan baris sebelumnya, dan baris pertama dipertahankan. Ukuran tabel turun dari 6 menjadi 5 baris. Setelah baris dihapus, nomor indeks menjadi loncat (ada yang hilang), jadi kita rapikan dengan reset_index(drop=True) agar nomornya berurutan lagi. Perhatikan bahwa hasilnya disimpan kembali ke df. Tanpa itu, df tidak berubah.
drop_duplicates() dijalankan sekali lagi? Tebak dulu!🧪 Tugas Praktik 36: Menangani Data Kosong
⌨️ Ketik di sel kode, lalu jalankan:
print("Jika baris kosong dibuang:", df.dropna().shape)

rata = df["Nilai"].mean()
print("Rata-rata nilai yang ada:", rata)

df["Nilai"] = df["Nilai"].fillna(rata)
print(df)
✅ Hasilnya:
Jika baris kosong dibuang: (4, 3)
Rata-rata nilai yang ada: 83.5
   Nama Kelas  Nilai
0  Budi   X-1   87.0
1  Sari   X-1   90.0
2  Andi   X-2   83.5
3  Dedi   X-2   75.0
4  Rina   X-1   82.0
💡 Penjelasan: dropna() membuang baris yang punya data kosong, sehingga tabel menyusut menjadi 4 baris dan datanya berkurang. fillna(rata) mengisi data kosong dengan nilai pengganti, di sini rata-rata nilai yang ada (83,5). Pilihan mana yang dipakai tergantung keadaan:
| Cara | Perintah | Cocok dipakai bila |
|---|---|---|
| Buang baris | df.dropna() |
Data kosong sedikit dan tidak penting |
| Isi dengan rata-rata | df["Nilai"].fillna(rata) |
Data kosong cukup banyak dan kita butuh semua baris |
🧪 Tugas Praktik 37: Merapikan Teks dan Tipe Data
⌨️ Ketik di sel kode, lalu jalankan:
df2 = pd.DataFrame({
    "Nama": [" budi", "SARI ", "andi"],
    "Kelas": ["x-1", "X-1 ", " x-1"],
    "Nilai": ["87", "90", "75"]
})

df2["Nama"] = df2["Nama"].str.strip().str.title()
df2["Kelas"] = df2["Kelas"].str.strip().str.upper()
df2["Nilai"] = df2["Nilai"].astype(int)

print(df2)
print("Rata-rata:", df2["Nilai"].mean())
✅ Hasilnya:
   Nama Kelas  Nilai
0  Budi   X-1     87
1  Sari   X-1     90
2  Andi   X-1     75
Rata-rata: 84.0
💡 Penjelasan: .str.strip() membuang spasi di depan dan belakang teks, .str.title() membuat huruf awal kapital (“budi” menjadi “Budi”), dan .str.upper() membuat semua huruf besar. Selain itu, nilai awalnya berupa teks ("87"), sehingga tidak bisa dirata-ratakan. Perintah astype(int) mengubahnya menjadi bilangan bulat. Ingat perbedaan "87" dan 87 pada Praktik 2? Sekarang kamu membetulkannya dengan pandas.
astype(int) menjadi astype(float). Apa bedanya pada hasil rata-rata dan tampilan nilainya?🧪 Tugas Praktik 38: Mini Proyek: Dari Data Kotor ke Rangkuman Kelas
⌨️ Ketik di sel kode, lalu jalankan:
import pandas as pd

mentah = {
    "Nama": ["Budi", "Sari", "Andi", "Sari", "Dedi", "Rina"],
    "Kelas": ["X-1", "X-1", "X-2", "X-1", "X-2", "X-1"],
    "Nilai": [87, 90, None, 90, 75, 82]
}

df = pd.DataFrame(mentah)
df = df.drop_duplicates().reset_index(drop=True)
df["Nilai"] = df["Nilai"].fillna(df["Nilai"].mean())

rekap = df.groupby("Kelas")["Nilai"].mean()
print(df)
print()
print(rekap.round(1))
✅ Hasilnya:
   Nama Kelas  Nilai
0  Budi   X-1   87.0
1  Sari   X-1   90.0
2  Andi   X-2   83.5
3  Dedi   X-2   75.0
4  Rina   X-1   82.0

Kelas
X-1    86.3
X-2    79.2
Name: Nilai, dtype: float64
💡 Penjelasan: Seluruh tahap pembersihan digabung: hapus data ganda, rapikan indeks, lalu isi data kosong dengan rata-rata. Setelah bersih, data dibingkai dalam DataFrame dan dirangkum dengan groupby("Kelas"), yaitu mengelompokkan baris berdasarkan kelas, lalu menghitung rata-rata nilai tiap kelompok. Inilah tahap pengolahan data yang menjadi bahan untuk grafik di Bagian I. Selamat! 🎉 Kamu sudah menjalani alur lengkap: data kotor → data bersih → informasi.
.mean() pada groupby dengan .max(). Siapa nilai tertinggi di tiap kelas? (petunjuk: yang tampil adalah nilainya)Rangkuman
- Data mentah perlu dibersihkan agar analisis tidak menyesatkan (“garbage in, garbage out”).
- Masalah umum: data ganda, data kosong (
NaN), teks tidak seragam, dan tipe data salah. - Periksa dulu dengan
isnull().sum()danduplicated().sum(). - Bersihkan dengan
drop_duplicates(),dropna()ataufillna(),str.strip(), danastype(). Simpan hasilnya kembali ke variabel. reset_index(drop=True)merapikan nomor baris setelah ada baris yang dihapus.- Data bersih dibingkai dalam DataFrame lalu dirangkum, misalnya dengan
groupby(). - Berlaku jujur: catat cara pembersihan, dan jangan mengubah data demi hasil yang bagus.
🌱 Pengayaan (Opsional)
Selain rata-rata, ada cara lain mengisi data kosong, misalnya dengan nilai tengah (median), yang lebih tahan terhadap nilai ekstrem. Coba ganti .mean() dengan .median() pada Praktik 36 dan bandingkan hasilnya.
Di Bagian I, data bersih seperti ini akan kita ubah menjadi grafik, lalu kita baca maknanya (interpretasi).
💗 Nilai Panca Cinta: Cinta Allah dan Rasul-Nya
Islam sangat menekankan kebersihan (thaharah) dan kejujuran. Membersihkan data adalah latihan kecil dari keduanya: kita membuang kotoran dalam data, tetapi tetap jujur, tidak memalsukan atau mengubah angka demi kepentingan sendiri. Teliti membersihkan, jujur dalam mencatat, dan bertanggung jawab atas hasil kerja adalah bagian dari sikap amanah yang mencerminkan cinta kepada Allah dan Rasul-Nya.
Refleksi: Pernahkah kamu tergoda mengubah angka (misalnya nilai atau hasil percobaan) agar terlihat lebih bagus? Apa yang akan kamu lakukan jika itu terjadi lagi?
📝 Tugas Siswa
Tugas Mandiri: Membersihkan Data Nilai Kelompokku
Setelah menyelesaikan Praktik 34–38, buat satu notebook baru bernama Tugas_Bersih_NamaKamu. Salin data kotor berikut ke sel kode pertama:
import pandas as pd

data = {
    "Nama": ["Rani", "Tono", "Wati", "Tono", "Yudi", "Zahra"],
    "Kelas": ["x-1", "X-2", " x-1", "x-2 ", "X-2 ", "x-1"],
    "Nilai": [80, 70, None, 70, 90, 85]
}
df = pd.DataFrame(data)
Lalu kerjakan:
- Periksa data: tampilkan jumlah data kosong dan jumlah data ganda.
- Rapikan kolom
Kelas(buang spasi dan samakan huruf besar). Lakukan ini sebelum menghapus data ganda! Mengapa urutannya penting? - Hapus data ganda, lalu rapikan nomor indeks.
- Isi data kosong dengan rata-rata nilai, lalu tampilkan tabel bersihnya.
- Hitung rata-rata nilai tiap kelas dengan
groupby.
| Pertanyaan | Jawaban |
|---|---|
| Tautan (link) notebook | … |
| Jumlah data kosong dan data ganda awal | … |
| Jumlah baris setelah dibersihkan | … |
| Rata-rata nilai kelas X-1 dan X-2 | … |
| Mengapa teks dirapikan dulu sebelum menghapus data ganda? | … |
Mengapa mencatat cara pembersihan data (misalnya “data kosong diisi rata-rata”) termasuk sikap jujur dan amanah? Berikan satu contoh dalam kehidupan sehari-hari.Jawaban: …………………………………………………………………
Kerjakan di Colab, lalu kumpulkan tautan notebook melalui link/aplikasi yang diinformasikan guru (sesuai kondisi dan kesepakatan dengan guru pengampu). Jika tidak memungkinkan memakai laptop, boleh dicatat dan difoto di buku tugas.